Zuletzt aktualisiert 17. Sept. 2026
|
5 Minuten
Medizinische Spracherkennung: Wie zuverlässig erkennen Sprachmodelle deutsche Fachbegriffe?

Martina | Jameda Redaktion
Eine aktuelle Studie hat 29 Spracherkennungsmodelle im deutschen medizinischen Kontext getestet und dabei Fehlerraten zwischen 3 % und über 20 % je nach Modell gemessen (Schuster et al., Hochschule Pforzheim/XPACE GmbH). Ob ein System wirklich jedes Fachwort zuverlässig erkennt oder am Ende doch Nacharbeit liegen bleibt, zeigt sich erst im Detail. Medizinische Spracherkennung wird an genau dieser Frage gemessen, wie Noa Notes im Praxisalltag zeigt.
Das Thema kurz und kompakt
- Belegte Qualität statt Werbeversprechen: Eine aktuelle Studie hat 29 ASR-Modelle im deutschen medizinischen Kontext getestet, mit Fehlerraten zwischen 3 % und über 20 % je nach Modell.
- Transkription ist nicht gleich Dokumentation: Erkennungsgenauigkeit und die anschließende inhaltliche Strukturierung durch ein Sprachmodell sind zwei getrennte Leistungsebenen.
- Multidisziplinäre Terminologie zählt: Von der Kardiologie bis zum FDI-Zahnschema braucht es mehr als einen großen Wortschatz, nämlich Kontextverständnis.
- Kombination aus Spracherkennung und Fachsprachmodell: Noa Notes verbindet beide Ebenen zu einem strukturierten Dokumentationsentwurf.
Transkription vs. Strukturierung: wie medizinische Fachbegriff-Erkennung technisch funktioniert
Wer über medizinische Spracherkennung spricht, meint oft zwei unterschiedliche Dinge gleichzeitig. Reine Diktiersoftware wie beispielsweise Dragon Medical One transkribiert Sprache in Echtzeit, während der Arzt aktiv und meist in vorgegebener Struktur diktiert. Das Ergebnis ist Fließtext, der zwar die gesprochenen Worte abbildet, aber keine eigene Ordnung mitbringt.
Moderne Dokumentationsassistenten gehen einen Schritt weiter: Sie dokumentieren das gesamte Arzt-Patienten-Gespräch im Hintergrund, ohne dass aktiv in vorgegebener Reihenfolge diktiert werden muss, und übernehmen anschließend auch die inhaltliche Strukturierung. Ein Sprachmodell ordnet die Aussagen dabei den passenden Kategorien wie Anamnese, Befund oder Therapie zu. Das Ergebnis ist in beiden Fällen ein Entwurf, den die Ärztin oder der Arzt prüft und freigibt, bevor er in die Patientenakte eingeht.
Der Unterschied zu klassischer Diktiersoftware liegt also nicht allein in der reinen Erkennungsgenauigkeit, sondern im Funktionsprinzip: aktives Diktat gegenüber passiver, strukturierter Gesprächsdokumentation. Eine erste Pilotuntersuchung der Studie von Schuster et al. (Hochschule Pforzheim/XPACE GmbH) zur Erkennung deutscher medizinischer Sprache, die die semantische Treue der Transkripte per LLM-Bewertung prüft, deutet darauf hin: Die semantische Informationstreue bleibt bei den leistungsstärksten Modellen bereits ohne zusätzliches Fine-Tuning des nachgelagerten Sprachmodells weitgehend erhalten, weil dieses Modell die Struktur stärker korrigiert als der reine Wortlaut. Transkriptionsgenauigkeit und nachgelagerte Strukturierung wirken damit auf zwei unterschiedlichen Ebenen zusammen, nicht im Widerspruch zueinander.
Was die aktuelle Studienlage zur Erkennungsgenauigkeit zeigt
Anbieterversprechen zur Erkennungsgenauigkeit sind in diesem Markt die Regel, belastbare Zahlen dazu die Ausnahme. Das gilt erst recht für allgemeine Chatbot-Lösungen, die gar nicht für medizinische Fachsprache trainiert sind. Die angeführte Studie setzt diesen Versprechen harte Fakten entgegen: 29 ASR-Modelle wurden anhand eines eigens erstellten Testdatensatzes aus simulierten Arzt-Patienten-Gesprächen geprüft.
Die vier Testszenarien
Das Testmaterial deckt vier realitätsnahe Fälle ab: einen Standardfall mit Verdacht auf Bandscheibenvorfall, einen Fall mit internistischer Fachterminologie bei Verdacht auf Divertikulitis, ein Szenario mit nicht-muttersprachlichem Akzent der behandelnden Ärztin bei Verdacht auf Beinvenenthrombose sowie ein Szenario mit starkem Patientendialekt bei Verdacht auf Morbus Fabry. Die Studienautoren stellen fest, dass gerade domänenspezifische Fachterminologie und akustisch herausfordernde Situationen wie Dialekte und Akzente die primären Fehlertreiber für die Erkennungsgenauigkeit sind.
Die Ergebnisse im Überblick
Die getesteten Modelle liegen weit auseinander, wie die folgende Übersicht zeigt:
Kommerzielle APIs wie AssemblyAI Universal erreichten damit das beste Ergebnis im Testfeld. Ältere oder kompakte Open-Source-Modelle zeigten dagegen Fehlerraten von über 20 %, was die Studienautoren für eine automatisierte medizinische Dokumentation als vermutlich unzureichend einstufen. Rein englischsprachige Modell-Checkpoints lieferten erwartungsgemäß keine brauchbare Transkription der deutschen Gespräche und dienten den Autoren als Negativkontrolle. Die Studie selbst ist an dieser Stelle nicht ganz konsistent: Die Ergebnistabelle führt den 12,6-%-Wert unter „Whisper Large-v3 (Distilled)“, der Fließtext an anderer Stelle unter „OpenAI Whisper Large-v3“. Der Wert selbst bleibt davon unberührt.
Die Studie ist inzwischen als begutachteter Konferenzbeitrag bei Springer erschienen (Schuster et al., BIS 2026, Lecture Notes in Business Information Processing, Bd. 584), ihre Ergebnisse sind damit peer-reviewed abgesichert: Sprachmodell-Wahl und domänenspezifisches Training entscheiden maßgeblich über die Praxistauglichkeit.
Sprecherzuordnung: ein oft übersehener Faktor
Neben der reinen Worterkennung prüft die Studie auch die Sprechertrennung, also ob ein System Aussagen korrekt der Ärztin oder dem Patienten zuordnet. Ohne zusätzliche Erweiterung liefern laut Studie nur die kommerziellen Modelle attributierte Transkripte direkt, Open-Source-Lösungen benötigen dafür separate Zusatzmodule. Für Systeme, die ein ganzes Gespräch statt eines einzelnen Diktats dokumentieren, ist diese Zuordnung ein eigenständiges Qualitätsmerkmal, unabhängig von der reinen Erkennungsgenauigkeit.
Multidisziplinäre Fachterminologie: von Kardiologie bis Zahnmedizin
Alle Fachrichtungen teilen die Notwendigkeit einer strukturierten Erfassung von Anamnese, Befund, Diagnose und Therapie. Die Unterschiede liegen in der Tiefe: Während in der Allgemeinmedizin oft viele kurze Konsultationen mit breitem Themenspektrum anfallen, benötigen Spezialisten wie Psychiater oder Kardiologen Raum für nuancierte, lange Gesprächsinhalte. Eine KI, die nur einzelne Fachwörter erkennt, reicht hier nicht aus, entscheidend ist das Kontextverständnis: die Fähigkeit, Fachbegriffe auch dann korrekt zuzuordnen, wenn sie in einem schnell gesprochenen Gespräch fallen.
Das FDI-Zahnschema als Beispiel
Ein besonders anschauliches Beispiel liefert die Zahnmedizin. Zahnärztinnen und Zahnärzte diktieren Befunde oft nach dem international gebräuchlichen FDI-Zahnschema, etwa „zwei sechs“ für den ersten Molaren oben links. Eine Spracherkennung, die nur den einzelnen Zahlenklang versteht, ohne den zahnmedizinischen Kontext zu kennen, würde eine solche Angabe leicht falsch protokollieren.
Multidisziplinäre Sprachintelligenz erkennt dagegen komplexe Terminologie von der Kardiologie über die Orthopädie bis hin zur Psychiatrie und ordnet auch fachspezifische Zahlenfolgen wie das Zahnschema korrekt zu.
Noise-Filterung: warum Smalltalk nicht in die Dokumentation gehört
Ein Arzt-Patienten-Gespräch ist akustisch und inhaltlich alles andere als einheitlich. Dialekte, Akzente und unterschiedliche Sprechtempi gehören zum Praxisalltag, eine Spracherkennung muss mit dieser akustischen Bandbreite zurechtkommen, noch bevor es um den Inhalt des Gesagten geht.
Und selbst wenn die Aussprache klar erkannt wird, ist nicht jede Aussage im Raum medizinisch relevant: Witze, Analogien oder beiläufiger Smalltalk gehören zum Praxisalltag, aber nicht in die Patientenakte. Eine gute Dokumentationslösung muss deshalb beides leisten: verschiedene Sprechweisen zuverlässig verstehen und irrelevante Inhalte selbstständig herausfiltern. Für die Nachbearbeitung bedeutet das einen spürbaren Unterschied: Wer bei der ohnehin erforderlichen ärztlichen Prüfung des Entwurfs nicht zusätzlich irrelevante Passagen streichen muss, gewinnt genau die Zeit zurück, die eine Dokumentationslösung eigentlich versprechen soll.
Noa Notes: multidisziplinäre Spracherkennung im Praxisalltag
Noa Notes verbindet die beiden zuvor beschriebenen Ebenen: ein auf medizinische Fachsprache trainiertes Sprachmodell für die Terminologie-Erkennung und die automatische Strukturierung des Gesprächs. Die Verarbeitung erfolgt dabei DSGVO-konform auf ISO-27001-zertifizierten Servern in Frankfurt, entwickelt von Jameda. Eine öffentlich benannte Wortfehlerrate für die eingesetzte Spracherkennungskomponente veröffentlicht Noa Notes aktuell nicht, dieser Wert lässt sich im Beratungsgespräch gezielt erfragen.
Wichtig dabei: Noa Notes übernimmt die Vorarbeit, nicht die Entscheidung, und liefert einen bereits vollständig strukturierten Dokumentationsentwurf. Sie prüfen das Ergebnis und geben es frei, bevor es in die Patientenakte eingeht, oft reicht dafür ein kurzer Blick, weil die inhaltliche Vorarbeit bereits erledigt ist. So bleiben Sie jederzeit die entscheidende Instanz, ohne selbst tippen zu müssen.
Worauf es bei der Anbieterwahl ankommt
Eine unabhängige Fehlerrate für jedes einzelne am Markt verfügbare Produkt liegt bislang nicht vor. Die vorgestellte Studie testet einzelne ASR-Modelle, nicht fertige Praxisprodukte. Wer eine Lösung bewertet, sollte deshalb gezielt nachfragen, statt sich auf allgemeine Zuverlässigkeits-Aussagen zu verlassen:
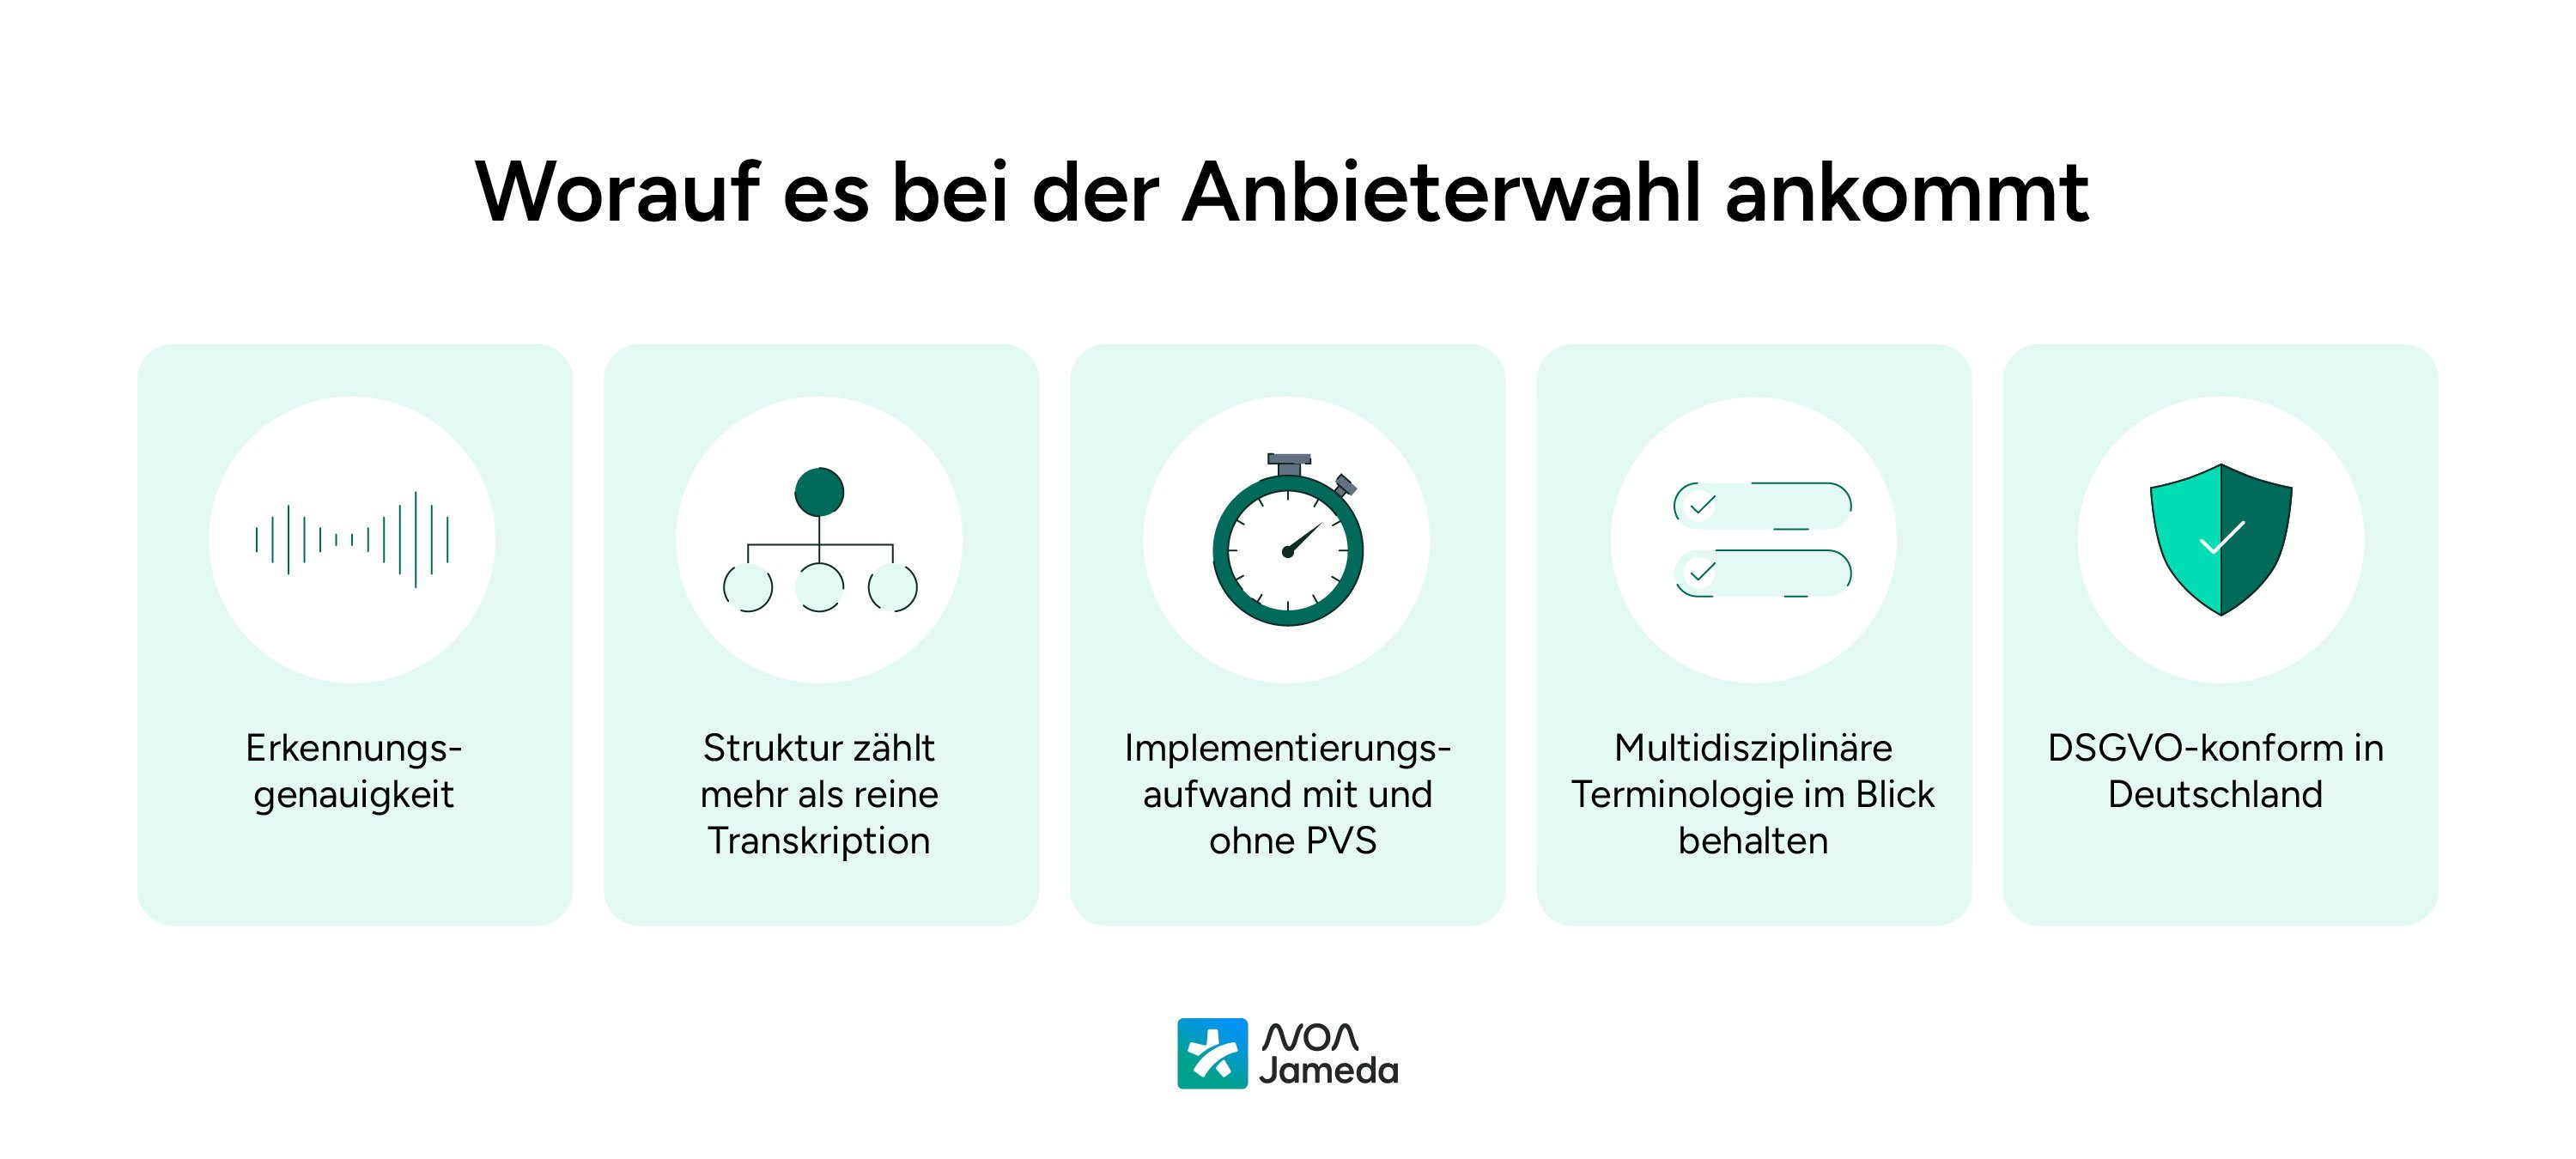
- Erkennungsgenauigkeit variiert stark: Je nach zugrundeliegendem Modell liegen die Fehlerraten zwischen 3 % und über 20 %, das lohnt eine gezielte Nachfrage beim Anbieter.
- Struktur zählt mehr als reine Transkription: Erst das Zusammenspiel aus Spracherkennung und Sprachmodell liefert eine vollständige Dokumentation.
- Geringer Implementierungsaufwand ohne PVS: Eine gute Lösung ist ohne IT-Projekt einsatzbereit, Noa Notes etwa lässt sich in rund 15-45 Minuten einrichten.
- Etwas mehr Aufwand mit PVS-Anbindung: Mit Anbindung an das Praxisverwaltungssystem liegt die Einrichtung bei rund 45 Minuten [PRÜFEN], danach läuft die Dokumentation direkt in die gewohnte Praxissoftware.
- Multidisziplinäre Terminologie im Blick behalten: Von Kardiologie bis Zahnmedizin sollte eine Lösung Fachvokabular nicht nur erkennen, sondern auch im richtigen Kontext einordnen.
- DSGVO-konform in Deutschland: Verarbeitung auf ISO-27001-zertifizierten Servern in Frankfurt, mehr dazu in den Datenschutz- und Sicherheitsinformationen von Noa Notes.
Am besten lässt sich das im eigenen Praxisalltag beurteilen: Noa Notes kostenlos testen und die Erkennungsqualität selbst prüfen.
Häufig gestellte Fragen
Wie zuverlässig erkennt Spracherkennungssoftware Fachbegriffe aus der Kardiologie oder Orthopädie?
Ein aktueller Benchmark für deutsche medizinische Sprache zeigt: Fachterminologie ist einer der größten Fehlertreiber bei der Erkennung, die getesteten Modelle liegen bei Fehlerraten zwischen 3 % und über 20 %. Entscheidend für die Praxis ist daher, ob ein System speziell auf medizinischer Fachsprache trainiert ist und Begriffe wie kardiologische Befunde oder orthopädische Diagnosen zuverlässig im klinischen Kontext einordnet, statt nur auf Wortebene zu erkennen.
Was unterscheidet automatisierte Dokumentation von klassischer Diktiersoftware im Medizinbereich?
Klassische Diktiersoftware transkribiert aktiv gesprochene, meist vorstrukturierte Diktate in Echtzeit. Moderne Dokumentationsassistenten dokumentieren dagegen das gesamte Gespräch im Hintergrund und strukturieren die Inhalte anschließend in die passenden Dokumentationsfelder. Der so entstandene Entwurf wird von der Ärztin oder dem Arzt geprüft und freigegeben, bevor er in die Patientenakte übernommen wird.
Erkennt eine Dokumentationslösung das FDI-Zahnschema bei Zahnärzten korrekt?
Eine Spracherkennung mit zahnmedizinischem Kontextverständnis ordnet Zahlenfolgen wie „zwei sechs“ korrekt dem international gebräuchlichen FDI-Zahnschema zu, statt sie als beliebige Zahl misszuverstehen. Das setzt Training auf fachspezifische Sprachmuster voraus, nicht nur einen großen allgemeinen Wortschatz.
Erfasst die Spracherkennung auch, wer im Gespräch spricht, Arzt oder Patient?
Laut Studie liefern ohne Zusatzmodule nur kommerzielle Modelle die Sprecherzuordnung direkt mit, bei Open-Source-Lösungen braucht es dafür separate Erweiterungen. Für Systeme, die ein ganzes Gespräch statt eines Diktats dokumentieren, ist diese Zuordnung ein eigenständiges Qualitätsmerkmal.
Hinweis: Noa Notes erstellt Dokumentationsentwürfe auf Basis von Spracherkennung, keine Diagnosen oder Therapieempfehlungen. Jeder Entwurf wird von der Ärztin oder dem Arzt geprüft und freigegeben, bevor er in die Patientenakte übernommen wird.
