Zuletzt aktualisiert 17. Sept. 2026
|
5 Minuten
Wie genau ist KI-Dokumentation? Studienlage, Fehlerquellen und Prüfablauf

Martina | Jameda Redaktion
Sie lesen den KI-Entwurf eines Arztbriefs durch und stocken bei einer Zahl, die Ihnen nicht ganz plausibel vorkommt. Genau hier setzt die Frage nach der Genauigkeit von KI-Dokumentation an: Ist das ein Ausreißer oder ein systematisches Problem? Studien zu diesem Thema wirken auf den ersten Blick widersprüchlich. Die eine spricht von über 90 % nutzbaren Dokumenten, die andere von Halluzinationsraten über 20 %. Beide Zahlen können gleichzeitig stimmen, wenn man weiß, welche Stufe der Dokumentation sie tatsächlich messen. Eine Demo zeigt Ihnen, wie Noa Notes genau diese Prüfschritte im Alltag sichtbar macht.
Das Thema kurz und kompakt
- Genauigkeit ist eine Kette, kein Einzelwert: Transkription, strukturierte Notiz und ärztliche Freigabe sind drei getrennte Prüfebenen, die unterschiedliche Fehlerraten zeigen.
- Die Studienlage ist jung, aber eindeutig: Peer-reviewed Untersuchungen zeigen Fehlerraten zwischen wenigen und über 25 Prozent, je nach Messebene und Fachrichtung.
- Fehlerquellen sind konkret benennbar: Dialekt, Nebengeräusche, Fachterminologie und unstrukturierte Mehrpersonen-Gespräche wirken sich nachweislich auf die Erkennung aus.
- Noa Notes macht die letzte Stufe der Kette sichtbar: Jeder Dokumentationsentwurf wird von Ihnen geprüft und freigegeben, bevor er in die Patientenakte eingeht, und spart dabei bis zu 75 % der Dokumentationszeit – jetzt kostenlos testen.
Was „Genauigkeit" bei KI-Dokumentation eigentlich bedeutet
Eine einzelne Prozentzahl sagt wenig darüber aus, wie zuverlässig ein KI-Dokumentationsassistent tatsächlich arbeitet. Genauigkeit lässt sich auf drei unterschiedlichen Stufen messen, und jede Stufe liefert ein anderes Bild. Die erste Stufe ist die reine Spracherkennung: Wie präzise wandelt das System das gesprochene Wort in Text um? Fehler auf dieser Ebene heißen Transkriptionsfehler, etwa wenn ein Fachbegriff missverstanden wird. Die zweite Stufe betrifft die daraus abgeleitete strukturierte Notiz: Fehlt relevante Information (Auslassung), wird etwas fälschlich hinzugefügt (Kommission), oder erfindet das Modell plausibel klingende, aber tatsächlich nicht besprochene Inhalte (Halluzination)? Die dritte Stufe ist das Dokument, das nach ärztlicher Prüfung tatsächlich in die Patientenakte eingeht.
Diese Unterscheidung löst einen scheinbaren Widerspruch auf, der in der öffentlichen Debatte häufig übersehen wird. Eine Studie des Universitätsklinikums Freiburg ergab, dass beim besten getesteten Sprachmodell 93,1 % der erzeugten Arztbriefe nach nur geringfügigen Korrekturen klinisch nutzbar waren. Andere internationale Untersuchungen berichten dagegen von deutlich höheren Fehlerraten. Der Unterschied liegt in der Messebene: Freiburg bewertete das Ergebnis nach der ärztlichen Korrektur, während viele internationale Studien die unkorrigierte Rohausgabe der KI untersuchen, also genau die Stufe vor der ärztlichen Prüfung.
Was die Studienlage tatsächlich zeigt
Für die Freiburger Studie trainierte ein Forschungsteam drei Sprachmodelle mit Akten von über 82.000 Patientenkontakten und verglich die Ergebnisse mit 509 ärztlich verfassten Entlassbriefen. Die größte methodische Herausforderung lag laut Studienleitung darin, die medizinische Fachterminologie und die Struktur klinischer Berichte in deutscher Sprache korrekt abzubilden. Internationale Vergleichsstudien zeichnen dagegen ein durchwachseneres Bild auf der Transkript- und Notizebene:
- Freiburg (Deutschland): bestes, nicht kommerzielles Modell lieferte 93,1 % klinisch nutzbare Arztbriefe nach geringfügiger Korrektur.
- Eine Untersuchung über vier Ambient-Scribe-Plattformen: durchschnittlich 13,9 Transkriptionsfehler pro Fall, davon 19,5 % in der finalen Notiz übernommen; mittlerer Fehleranteil in den Notizen 26,3 %.
- Eine PDQI-9-Vergleichsstudie über fünf Fachrichtungen: Halluzinationen in 31 % der KI-Notizen gegenüber 20 % bei ärztlichen Referenznotizen, KI-Notizen dennoch leicht bevorzugt.
- Ein systematischer Rapid Review: nur 6 von 144 untersuchten Studien mit belastbarer Real-World-Evidenz zur tatsächlichen Wirksamkeit.
Die Evidenzlage ist damit jung und methodisch heterogen. Einzelne Studienergebnisse sollten als Bandbreite mit Kontext gelesen werden, nicht als feste, branchenweite Konstante.
Wo Fehler in der Praxis wirklich entstehen
Vier Faktoren tauchen in der Forschung immer wieder als konkrete Fehlerquellen auf. Der erste ist sprachliche Variation: Assistenzärztinnen und -ärzte einer Studie zu Ambient-Scribes in der Familienmedizin berichteten von Genauigkeitsproblemen bei Akzenten, leiseren Stimmen und Sprachbeeinträchtigungen sowie bei unstrukturierten Gesprächen mit mehreren Beteiligten. Der zweite Faktor ist die Fachterminologie: Variationen in der medizinischen Sprache, umgangssprachliche Begriffe und die einfache Sprache pädiatrischer Patientinnen und Patienten wurden in derselben Studie als konkrete Quellen für Transkriptionsfehler genannt.
Der dritte Faktor betrifft die Trainingsdaten selbst: Ein Teilnehmer wies darauf hin, dass die Genauigkeit eines Systems vom verwendeten Trainingsdatensatz abhängt, und dieser kann verzerrt sein. Mehrsprachigkeit wird in der bisherigen Forschung nicht separat quantifiziert, folgt aber logisch aus den ersten beiden Punkten: Jede zusätzliche Sprachvariation erhöht das Risiko eines Erkennungsfehlers. Der vierte Faktor ist die Fachrichtung selbst. In der Kardiologie, wo Dokumentation präzise und zeitkritische Details erfordert, können KI-bedingte Fehler laut einem Übersichtsartikel ein größeres Risiko bergen, was eine fachrichtungsspezifische Validierung nahelegt.
Warum der ärztliche Prüfablauf die eigentliche Genauigkeitsgarantie ist
Keines der in der Forschung untersuchten Systeme verzichtet auf die lückenlose ärztliche Durchsicht vor der Übernahme in die Akte, unabhängig von der jeweiligen Rohfehlerrate. Das ist der eigentliche Kern der Genauigkeitsfrage. Die KI liefert einen Entwurf, keine fertige Dokumentation. Genauigkeit entsteht erst durch die Kombination aus KI-Erkennung und menschlicher Prüfung.
Ein Vergleich relativiert zusätzlich die Vorstellung, KI sei per se riskanter als der bisherige Standard: Eine prospektive Studie am Groote-Schuur-Krankenhaus in Südafrika fand, dass handschriftliche Notizen mindestens fünfmal höhere Raten an moderaten bis schweren Halluzinationen, Verzerrungen, Auslassungen und klinisch relevanten Fehlern aufwiesen als ein KI-gestützter Ambient Scribe. Die eigentliche Gefahr liegt deshalb nicht allein in der KI-Fehlerrate, sondern im sogenannten Automation Bias, also der Tendenz, eine professionell formatierte KI-Ausgabe unkritisch zu übernehmen. Genau deshalb prüfen Sie das Ergebnis und geben es frei, bevor es in die Patientenakte eingeht. Dieser Schritt ist keine Formalität, sondern der Moment, in dem Genauigkeit tatsächlich entsteht.
Woran Sie belastbare Genauigkeit im Anbietervergleich erkennen
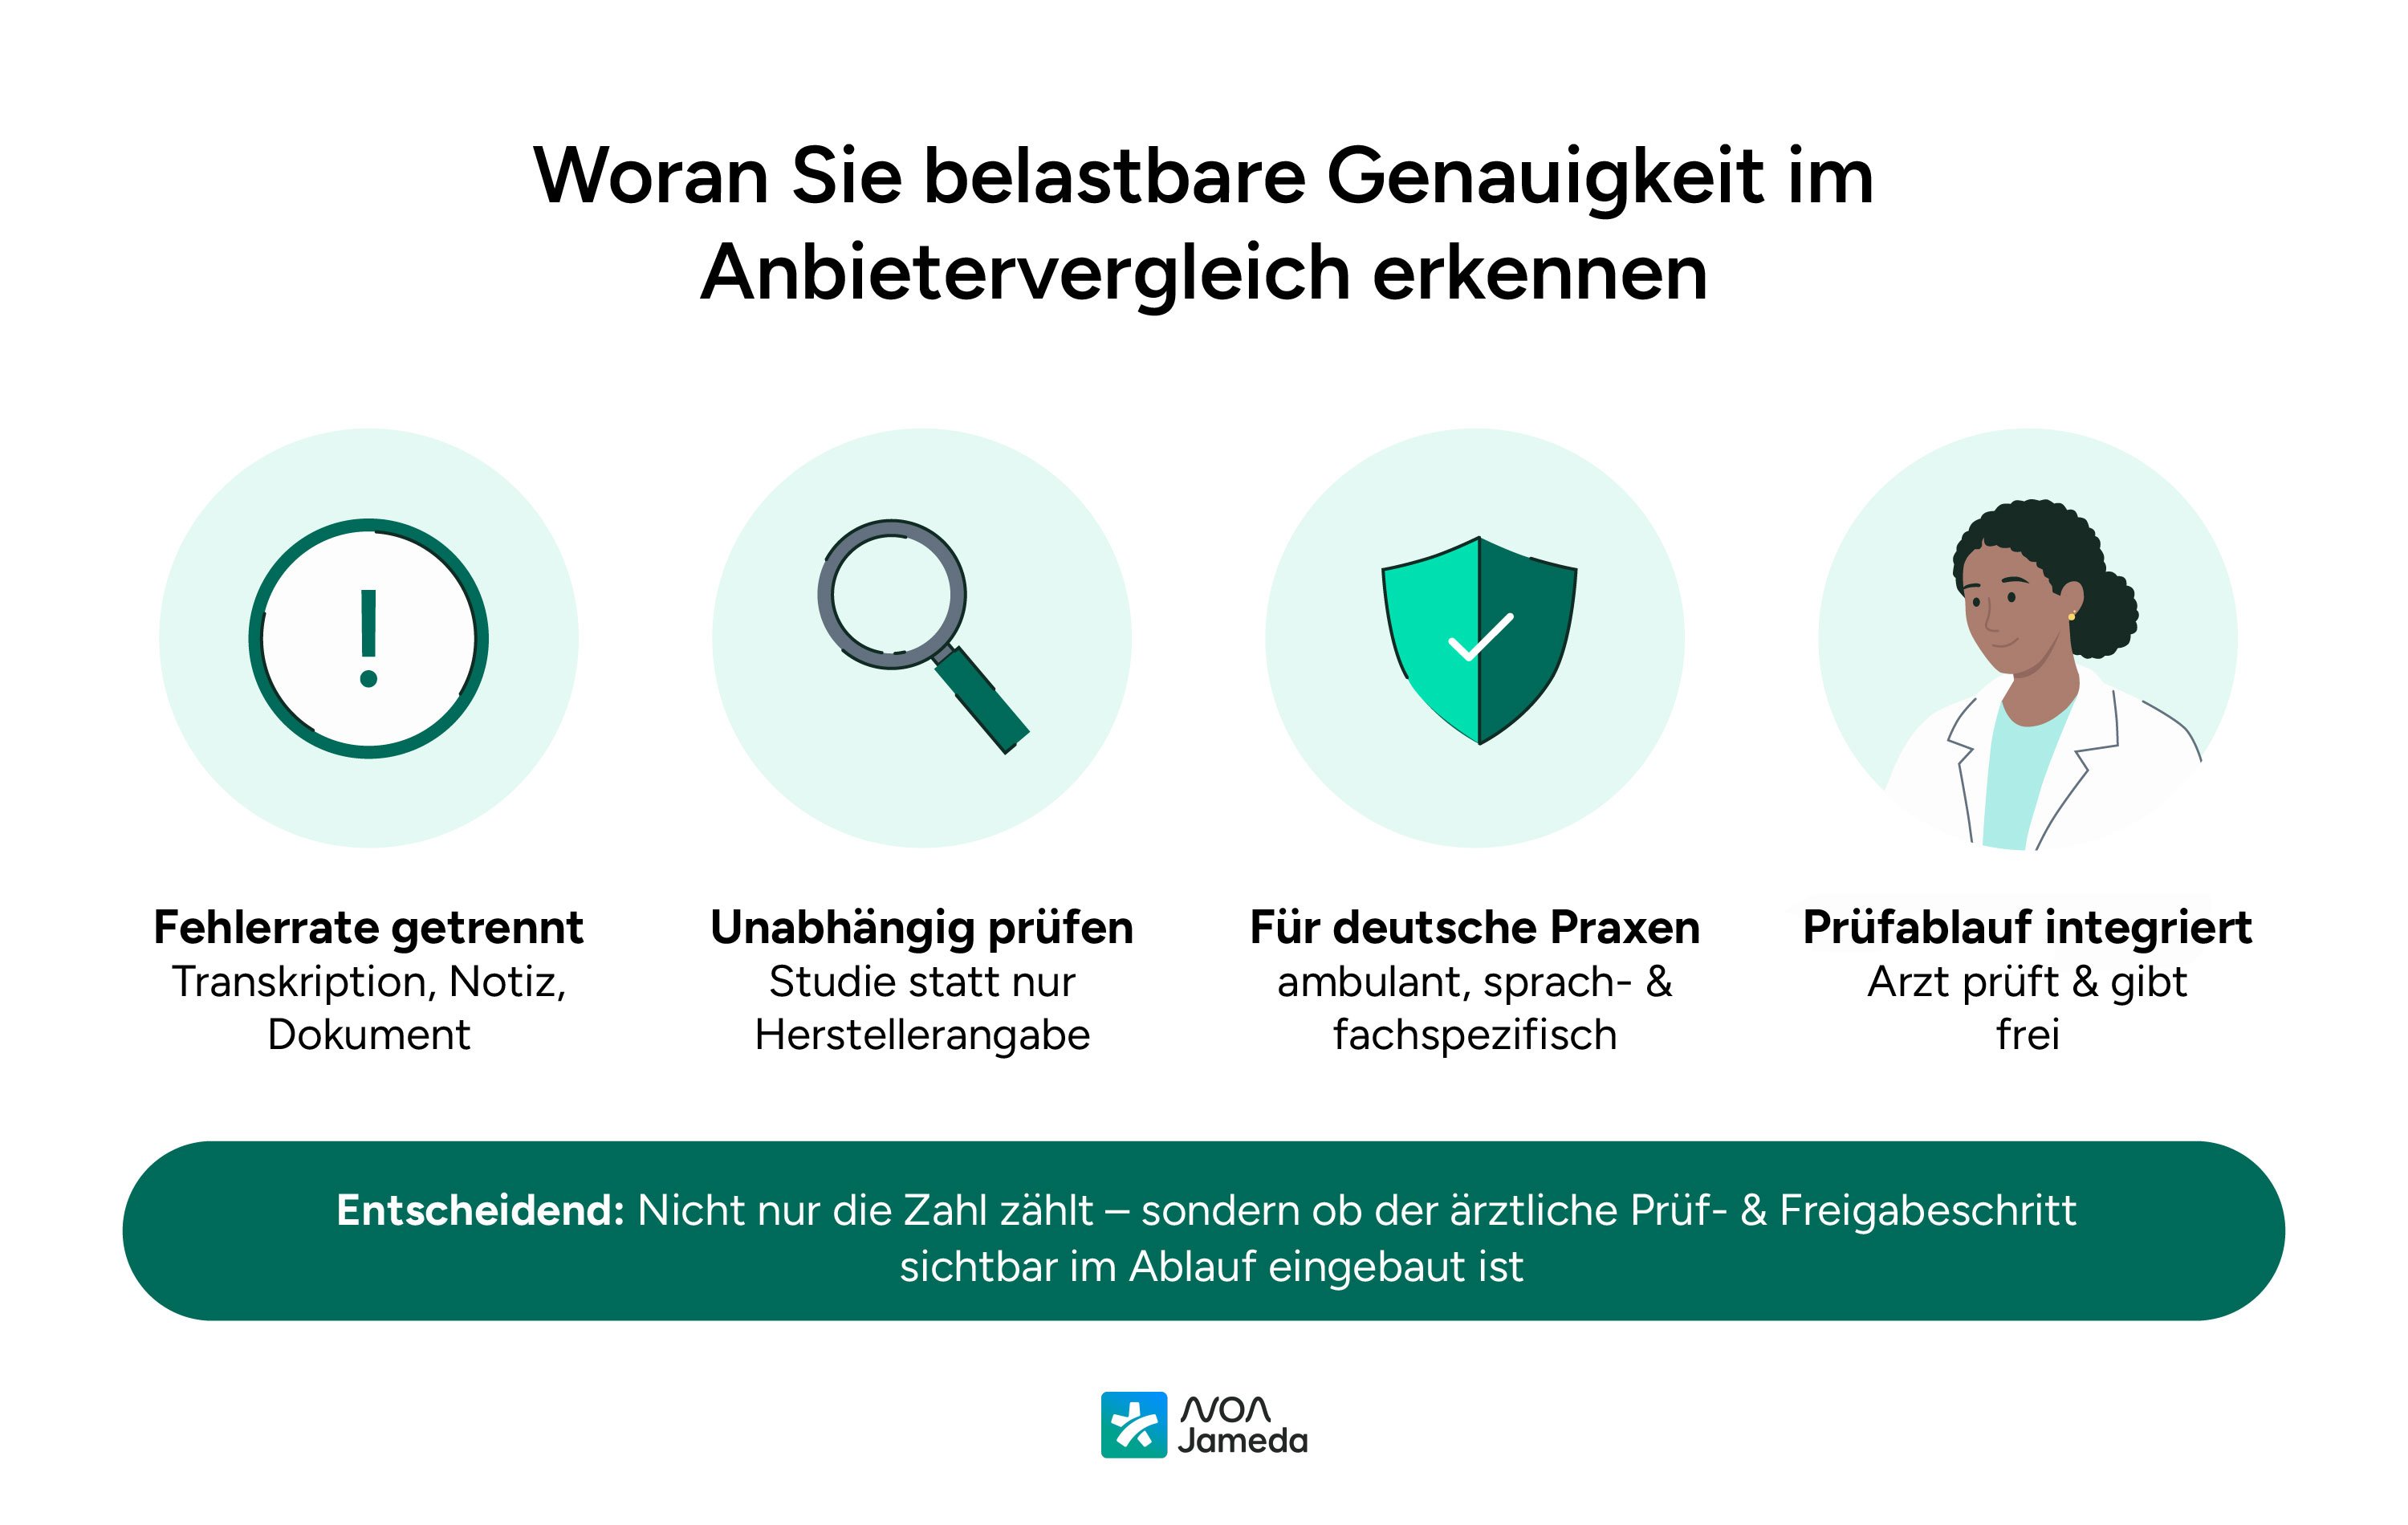
Eine Genauigkeitsangabe im Marketingtext eines Anbieters ist erst dann aussagekräftig, wenn sie sich einordnen lässt. Aus der Forschung lassen sich vier Prüffragen ableiten, mit denen Sie eine Angabe realistisch bewerten können.
- Wird die Fehlerrate nach Kategorie getrennt ausgewiesen, also Transkription, Notiz oder freigegebenes Dokument, statt als eine einzelne, undifferenzierte Zahl?
- Stammt die Zahl aus einer unabhängigen, begutachteten Studie oder ausschließlich aus Herstellerangaben ohne externe Überprüfung?
- Ist die Studie sprach- und fachrichtungsspezifisch für den deutschen, ambulanten Praxisalltag, oder wurde sie aus einem anderen Versorgungskontext übertragen?
- Wird der ärztliche Prüfablauf als integraler Bestandteil der Genauigkeitsgarantie beschrieben, oder taucht er nur als Compliance-Fußnote auf?
Der letzte Punkt ist dabei der eigentlich entscheidende: Eine Lösung, die den Prüf- und Freigabeschritt sichtbar in den Arbeitsablauf einbaut, adressiert die Genauigkeitsfrage strukturell und nicht nur auf dem Papier.
Wie Noa Notes die ärztliche Prüf- und Freigabepflicht konkret umsetzt
Noa Notes ist als Dokumentations-KI der Medizinprodukteklasse I nach MDR eingestuft und greift nicht in medizinische Entscheidungen ein. Das System transkribiert das Patientengespräch, strukturiert die Inhalte nach den üblichen Abschnitten wie Anamnese, Befund und Therapieplan, und legt Ihnen den Entwurf zur Prüfung vor. Erst wenn Sie das Ergebnis kontrolliert, korrigiert und freigegeben haben, geht es in die Patientenakte ein. Es schreibt zu keinem Zeitpunkt autonom in die Akte. Die Datenverarbeitung erfolgt auf ISO 27001-zertifizierten Servern in Frankfurt im Einklang mit der DSGVO; Noa Notes wird von Jameda, Teil der DocPlanner-Gruppe, betrieben.
Diese Struktur verbindet die beiden Dinge, die in der Genauigkeitsdebatte oft gegeneinander ausgespielt werden: Zeitersparnis und Kontrolle. Ärztinnen und Ärzte, die Noa Notes nutzen, reduzieren im Schnitt 75 % der Dokumentationszeit, ohne die abschließende inhaltliche Verantwortung abzugeben. Die Sorgfaltspflicht bleibt bei Ihnen, der administrative Aufwand davor sinkt dagegen um die bereits genannten 75 %. Genau das macht den Unterschied zwischen einem Werkzeug, das Vertrauen verdient, und einem, das nur Arbeit verlagert.
Fazit: Was für die Genauigkeit von KI-Dokumentation zählt
- Genauigkeit ist eine dreistufige Kette: Transkription, strukturierte Notiz und ärztliche Freigabe entscheiden gemeinsam über das Ergebnis.
- Die Studienlage variiert je nach Messebene: Freiburg maß 93,1 % klinisch nutzbare Arztbriefe nach ärztlicher Korrektur, internationale Studien auf Rohebene teils über 25 % Fehleranteil.
- Vier Fehlerquellen sind bekannt: Dialekt, Nebengeräusche, Fachterminologie und Verzerrungen in den Trainingsdaten wirken sich nachweislich auf die Erkennung aus.
- Die ärztliche Prüfung ist die eigentliche Garantie: Kein Entwurf geht ohne Ihre Kontrolle und Freigabe in die Patientenakte.
- Die Einrichtung ist schnell erledigt: Je nach PVS-Anbindung dauert sie 15 bis 45 Minuten.
- Noa Notes spart dabei bis zu 75 % der Dokumentationszeit: Mehr zur Zeitersparnis erfahren.
Der letzte Schritt in dieser Kette, die ärztliche Freigabe, garantiert die Genauigkeit tatsächlich, unabhängig davon, wie gut die vorherigen Stufen bereits funktionieren. Wer bei der Anbieterwahl genau auf diesen Punkt achtet, trifft eine fundierte Entscheidung. Eine Demo anfordern zeigt Ihnen diesen Prüfablauf direkt in Noa Notes.
FAQ
Wie wird die Genauigkeit von KI-Dokumentationsassistenten wie Noa Notes gemessen?
Genauigkeit lässt sich auf drei Ebenen messen: der reinen Spracherkennung, der daraus abgeleiteten strukturierten Notiz und dem final freigegebenen Dokument. Forschende nutzen dafür unterschiedliche Bewertungsraster, etwa das Physician Documentation Quality Instrument (PDQI-9), das die Qualität klinischer Notizen anhand mehrerer Kriterien bewertet. Eine Genauigkeitsangabe ist nur dann aussagekräftig, wenn klar ist, welche dieser Ebenen sie tatsächlich beschreibt.
Welche Fehlerquellen gibt es bei KI-gestützter Dokumentation für niedergelassene Ärztinnen und Ärzte?
Die Forschung nennt vier wiederkehrende Faktoren: sprachliche Variation wie Akzente oder leisere Stimmen, medizinische Fachterminologie und umgangssprachliche Begriffe, unstrukturierte Gespräche mit mehreren Beteiligten sowie mögliche Verzerrungen in den Trainingsdaten des Systems. Jeder dieser Faktoren kann die Erkennungsgenauigkeit einzeln oder in Kombination beeinflussen, weshalb eine sorgfältige Prüfung des Entwurfs vor der Freigabe wichtig bleibt.
Kann KI in der Arztpraxis Diagnosen oder Therapieentscheidungen verfälschen?
Noa Notes ist eine Dokumentations-KI und trifft keine Diagnose- oder Therapieentscheidungen. Das System erstellt ausschließlich Entwürfe für die medizinische Dokumentation, die Sie prüfen und freigeben. Das unterscheidet Dokumentations-KI grundlegend von diagnostischer KI, die als Medizinprodukt höherer Risikoklasse eingestuft ist und in medizinische Entscheidungen eingreifen würde.
Wie schützt die ärztliche Freigabepflicht vor Fehlern in der KI-Dokumentation?
Kein Entwurf gelangt ohne Ihre Prüfung in die Patientenakte. Sie kontrollieren, korrigieren wenn nötig und geben das Ergebnis erst dann frei. Diese Freigabepflicht wirkt der größten Gefahr entgegen, dem sogenannten Automation Bias, also der unkritischen Übernahme einer professionell formatierten, aber möglicherweise fehlerhaften KI-Ausgabe.
Woran erkennen Ärztinnen und Ärzte beim Anbietervergleich eine belastbare Genauigkeitsangabe?
Vier Punkte helfen bei der Einordnung: eine nach Kategorie getrennte Fehlerrate, die Herkunft der Zahl aus einer unabhängigen Studie statt aus reinen Herstellerangaben, die sprach- und fachrichtungsspezifische Übertragbarkeit auf den deutschen Praxisalltag und die Frage, ob der ärztliche Prüf-Workflow als struktureller Bestandteil der Genauigkeit beschrieben wird oder nur als Fußnote.
Rechtlicher Hinweis
Noa Notes erstellt Dokumentationsentwürfe und ersetzt keine medizinische Beratung. Jede Ärztin und jeder Arzt prüft und gibt das Ergebnis frei, bevor es in die Patientenakte eingeht.
